KEY POINTS
本文重點
- Search Console 曝光從一天七百多次掉到 2 次,不管把正常波動抓得多寬都包不進去,應該先當成異常訊號,而不是工具延遲。
- 原因在「網頁索引」報表:687 個頁面顯示「已檢索,目前尚未建立索引」,大多是一次批次產生、內容很薄的指標字典頁。
- 依 Drivetrain Model 的順序(目標、槓桿、資料、模型)來看,該盯的是「收錄」這個槓桿,而不是「曝光」這個結果。
- 上線前的 GA4 流量有不少是團隊自己,要先用內部流量篩選分開,正式推廣後才分得出外部訪客。
8 月底在 Minerva 修了一門課,CS312,中文大概可以理解成「以資料為本的決策」。
第一堂課講完一個叫做 Drivetrain Model 的框架之後,課前教材留了一題很簡單的自我檢查:
想一個工作上曾經遇過的問題,用這個框架重新描述一次。
當時我想了幾個例子,都覺得不太對,就先放著。
一直到這個禮拜,團隊正在準備讓一個 Data Studio 範本與教學網站正式對外。我把過去三個月的數據重新翻出來,從 Search Console 到 GA4,一層一層做了一次體檢,才突然發現:
原來這一題的答案,一直都在手邊。
7 月的那一天
這個網站還沒有正式宣布推出。
但為了能夠邊做、邊測、邊調整,從夏天開始網站其實就已經開著,教學文章也陸續放了上去。
7 月初,它已經開始在 Google 搜尋上出現曝光。
最多的一天,七百多次。
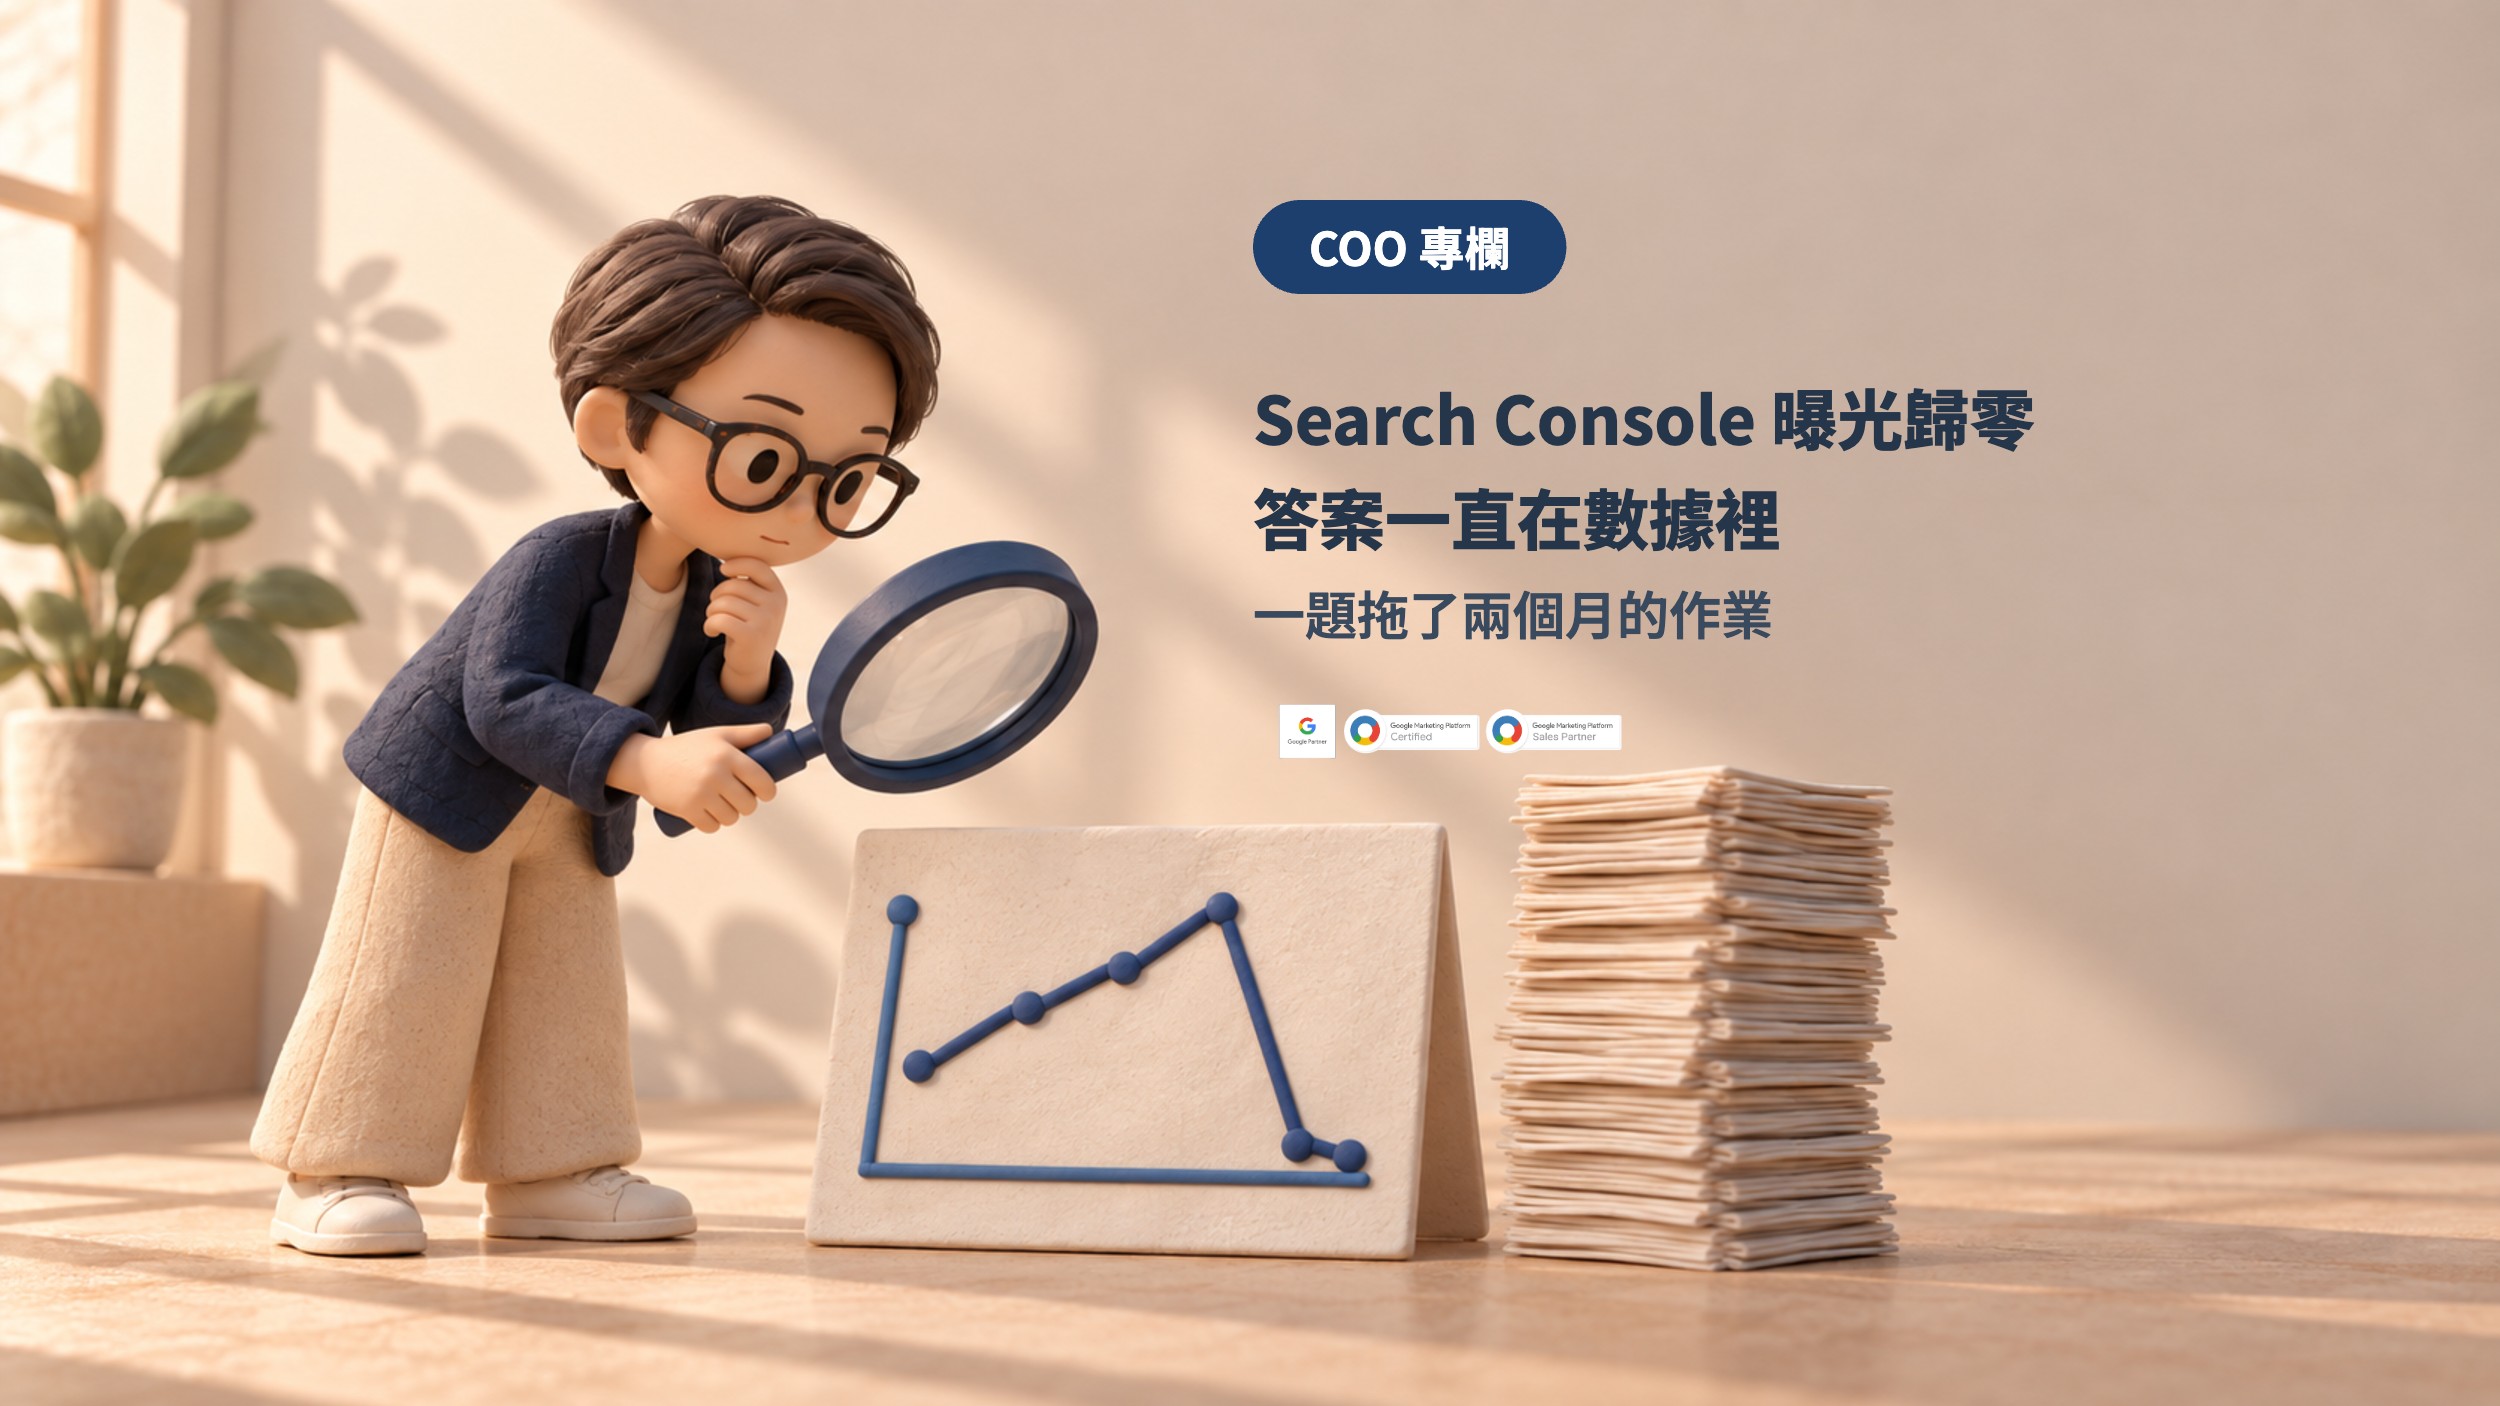
隔天,變成了 2。之後一直到 10 月初,幾乎每天都是 0。
當時團隊會議有討論到這件事。
那時的判斷是:GA4 還看得到自然搜尋進來的人,網站應該不是真的從 Google 消失,比較有可能是 Search Console 的資料沒有完整回傳,可以再觀察幾天。
還有一個沒有特別說出口,但現在回頭看也很合理的背景:
反正網站還沒有正式上線。
所以這件事就先被放過去了。
這個解釋其實不是沒有道理。數據工具偶爾延遲、漏資料、介面不同步,本來就不是什麼罕見的事。
真正的問題是:
它是第一個聽起來合理的解釋,而我們停在了那裡。
後來一直到 10 月重新檢查,才真正把原因找出來。
那不是工具的 bug,而是 Google 在這個網站正式推出之前,就已經先對它做了判斷,把大量頁面排除在搜尋結果之外。
先不要急著解釋,先問:這個變化正常嗎?
CS312 有一堂課花了不少時間談預測區間(Prediction Interval)。
白話一點說,如果要猜明天一間飲料店會賣幾杯飲料,比起說「明天會賣 120 杯」,更合理的說法可能是:
明天大概會落在 100 到 140 杯之間。
這個概念真正讓我有感的地方,其實不是「預測明天」,而是它可以反過來幫助判斷:
今天發生的事情,到底還算不算正常?
如果今天賣了 118 杯,落在合理區間裡,那可能只是一般波動。
但如果只賣了 3 杯,那就不是一句「今天生意比較差」可以帶過去的事。一定有什麼改變了。
回頭看 7 月的網站數據也是一樣。
一個還在籌備中的網站,今天曝光多一點、明天少一點,很正常。但從七百多次直接掉到 2 次,不管把正常波動的範圍拉得多寬,都很難把它包進去。
這時第一個反應應該不是「可能工具怪怪的」,而是:
「有什麼事情改變了?」
現在回頭看,當時真正少掉的不是一份報表,而是這一步判斷:先確認這是一個正常波動,還是一個異常訊號,再決定需不需要往下追。
用 Drivetrain Model 再走一次
Drivetrain Model 本身其實不複雜。它只是提醒,在一頭栽進一堆數字之前,先依序回答四件事:
1. Objective:到底想要什麼結果?
這個網站真正的目標,不是「把流量做高」,而是:
讓正在找 Data Studio、GA4、Search Console 等相關教學的人,能夠透過搜尋找到這些內容。
2. Levers:真正能控制的是什麼?
曝光數不是直接可以調整的東西。真正能動的,是:
- 哪些頁面能夠被 Google 收錄
- 頁面內容是否值得被收錄
- 網站架構與內容品質是不是讓搜尋引擎理解得了
也就是說,比起盯著「曝光掉了多少」,真正該看的其實是前面的槓桿。
3. Data:哪一份資料最能告訴我槓桿有沒有作用?
答案不是只有 Search Console 首頁上的曝光與點擊,而是裡面的「網頁索引狀態」。
那份報告會一頁一頁告訴你:哪些被收錄、哪些沒有,以及為什麼沒有。
而答案其實從 7 月開始就一直放在那裡。687 個頁面顯示:
「已檢索,目前尚未建立索引。」
意思是 Google 已經來看過了,但暫時決定不把這些頁面收進搜尋結果裡。
往下追之後才發現,這些頁面大多是當時為了快速建立內容,一次批次產生的指標字典頁。單頁內容很少、結構又高度相似。原本以為是在增加網站內容量,最後反而可能讓整體品質訊號變差。
數據其實從來沒有不見。只是那時候,我們看的是最後面的「結果」,而不是前面的「槓桿」。
如果對 Search Console 還不熟,網站裡也整理了一篇比較基礎的入門文章:Search Console 入門:曝光、點擊、CTR 與平均排名怎麼看。
4. Models:這些槓桿,怎麼影響最後的結果?
這一步其實就很直觀了。
被正確收錄、有足夠內容價值的頁面越多,被搜尋到的機會自然越高。反過來,如果網站裡有大量相似、內容又非常薄的頁面,即使頁數很多,也不代表搜尋表現會比較好。
更多,不一定等於更好。
很多時候,真正需要管理的不是「數量」,而是訊號的品質。
還有一個藏在數字裡的人
這次體檢也讓我找到另一件很有趣的事。
8 月到 9 月中,從 GA4 看,這個網站其實一直有流量,平日一天十幾到三十多個工作階段。如果只看總數,甚至會覺得:嗯,還沒正式推出,就已經有人來了。
但把資料拆開之後,畫面開始有點不一樣。
這些流量幾乎只出現在平日,週末接近 0;超過一半的互動集中在同一個行政區;而且不少工作階段停留得特別久。
看到這裡,其實答案差不多已經出來了。
那不是一群熱情的早期使用者。
是我們自己。
因為在籌備期間,最常進出這個網站的人,就是正在後台上範本、寫文章、修改內容、測功能的同事。團隊的工作節奏,同時決定了兩件事:網站有多少流量,以及網站看起來有多「活躍」。
CS312 在談「相關不等於因果」時,有一個很常見的例子:
下雨天,便利商店雨傘銷量增加,路上的積水也增加。但不是雨傘賣越多,積水就越深,而是背後有一個共同因素:下雨。
在分析裡,這種沒有被放進模型,卻同時影響我們觀察結果的因素,可以視為一種遺漏變數(Omitted Variable)。
在這個網站裡,那場「雨」就是:
內部流量。
如果沒有在正式上線前先把這件事情弄清楚,之後推廣開始,外部訪客和同事自己的使用行為全部混在一起,看到流量增加時,很容易以為行銷開始有效了。
但到底是真的有人來,還是只是團隊這幾天比較忙?就會變得很難回答。
GA4 本身就有方法可以辨識與排除內部流量,技術上並不是一件很困難的事情。唯一要小心的是,篩選器一旦啟用,被排除的資料就回不來了,所以最好先用「測試」狀態看幾天。
真正容易發生的,是籌備階段總會覺得:
「這個之後再處理就好。」
但很多資料問題,其實正是在「之後再說」裡慢慢長大的。
如果想看更多 GA4 常見資料異常的判讀方式,也可以參考這篇:GA4 (not set)、Unassigned 是什麼?一次搞懂 4 種常見資料異常。
框架很漂亮,現場通常沒那麼漂亮
寫到這裡,我其實也想替 7 月那一天的判斷說句公道話。
那一場會議有十幾個議題,Search Console 的異常只是其中一項。工具資料延遲確實會發生,網站又還沒有正式上線。
如果把自己放回當時的時間點,而不是站在三個月後看答案,那個判斷並沒有荒謬到哪裡去。
這也是我現在越來越喜歡這些框架的原因。它們不是拿來證明「看吧,當時做錯了」,而是幫忙建立一個更穩定的思考順序。
Drivetrain 不會自動告訴我們答案,Prediction Interval 也不會突然跳出來說哪裡壞了。它們真正提供的,也許只是幾個讓人慢半拍的問題:
這個變化正常嗎?
我現在看到的,是結果,還是能影響結果的那個東西?
這份資料裡,有沒有什麼人或因素被混在一起了?
在忙的時候,這些問題最容易被省略。偏偏很多時候,真正有價值的判斷,就藏在多問的那一句裡。
所以我最近開始提醒自己:不要等到出了問題,才把框架拿出來,而是把它變成日常開會、看報表、做決策時的一個固定動作。
因為課堂裡教的很多東西,其實都不是什麼全新的大道理。真正困難的,是能不能在事情很趕、資訊不完整、同時還有十件事等著處理的時候,依然記得用。
上線前,是看懂訊號最便宜的時候
這次檢查之後,團隊已經開始清理內容過薄的頁面,重新整理網站內容,也把重要教學文章重新送交 Google。GA4 的內部流量也會另外處理,讓正式推出之後看到的數據更接近真正的使用者行為。
這些事情現在做,都還算便宜。
網站還沒有正式推出,沒有大量推廣預算已經壓進來,也沒有一邊跑活動、一邊回頭補資料。
等真正上線以後才發現,代價就不只是多花幾個小時調整設定。有時候還包括錯誤的判斷、錯誤的優化方向,甚至錯過本來可以更早看見的訊號。
所以,CS312 那一題自我檢查,我大概算是拖了兩個月才交卷。
但最後留給自己的,不只是 Drivetrain Model 的四個步驟,而是一個現在很常提醒自己的問題:
在看到一個數字之後,我是真的理解它,還是只是替它找到了一個聽起來合理的解釋?
也想把另一個問題留給正在準備新網站、新產品、新服務的人:
正式上線那一天,你準備看哪一個數字?
還有:
那個數字,在真正上線以前,是不是其實早就已經在說話了?
常見問題
Search Console 曝光突然掉到 0,是工具的 bug 嗎?
有可能,但不建議先這樣假設。Search Console 的資料偶爾會延遲,可是如果曝光掉到遠低於平常的波動範圍,而且好幾天都沒有回來,比較可能是網站本身發生了變化。可以先打開「網頁索引」報表,看有沒有大量頁面被排除在索引之外。
「已檢索,目前尚未建立索引」是什麼意思?
Google 已經抓取過這個網頁,但還沒有把它放進搜尋索引,之後可能會收,也可能不會。如果大量頁面同時是這個狀態,值得檢查這些頁面是不是內容太少、彼此太相似。
Drivetrain Model 的四個步驟是什麼?
依序是目標(Objective)、槓桿(Levers)、資料(Data)、模型(Models):先定義想要的結果,再找出真正能控制的因素,接著確認哪些資料看得出這些因素有沒有作用,最後才建立「因素如何影響結果」的模型。這套方法最早由 Jeremy Howard、Margit Zwemer 與 Mike Loukides 在 2012 年提出。
網站還沒上線,GA4 需要先排除內部流量嗎?
需要,而且越早越好。籌備期的流量多半來自團隊自己,如果不先分開,正式推廣後外部訪客和內部使用紀錄會混在一起,很難判斷推廣有沒有效。GA4 的資料篩選器啟用後無法復原,建議先用「測試」狀態確認範圍。
延伸閱讀
這次體檢的網站,就是 CloudAD 的 Data Studio 範本與教學網站。GA4、Search Console 與 Data Studio 的實作教學都整理在這裡:
- Data Studio 範本與教學:全部教學
- Search Console 入門:曝光、點擊、CTR 與平均排名怎麼看
- GA4 (not set)、Unassigned 是什麼?一次搞懂 4 種常見資料異常
- AI 說的能信嗎?研究發現它有 63.7% 機率附和你的錯誤(COO 專欄:為什麼人容易停在第一個合理的解釋)
參考資料
- Google Search Console 說明,網頁索引報表
- Google Analytics 說明,篩除內部流量
- Jeremy Howard、Margit Zwemer、Mike Loukides,Designing great data products,O’Reilly Radar,2012 年 3 月
- Rob J Hyndman、George Athanasopoulos,Forecasting: Principles and Practice(第 3 版),5.5 Distributional forecasts and prediction intervals